Jeder Kurs auf Artemis, der Lernplattform, auf der viele TUM-Kurse laufen, kann seine Lernziele als Kompetenzen beschreiben. Übungen und Vorlesungseinheiten werden mit diesen Kompetenzen verknüpft, und aus diesen Verknüpfungen berechnet Artemis Fortschritt und Beherrschung jedes Studierenden und schlägt vor, was als Nächstes dran ist. Das Problem: Kursinhalte ändern sich ständig, die Verknüpfungen nicht. Wenn eine Verknüpfung veraltet, gibt es keine Fehlermeldung. Der Fortschrittsbalken ist einfach still und leise falsch.
Meine Bachelorarbeit, Agentic Orchestration for Autonomous Competency Management in Artemis, baut ein System aus LLM-Agenten, das solche Inhaltsänderungen bemerkt, die betroffenen Verknüpfungen neu bewertet und seine Änderungen anwendet, ohne vorher eine Lehrperson zu fragen. Genau dieser letzte Teil ist der unangenehme. Ein LLM eine Verknüpfung vorschlagen zu lassen, ist einfach. Es in Kursdaten schreiben zu lassen, die Studierende sehen, ist ein anderes Problem.
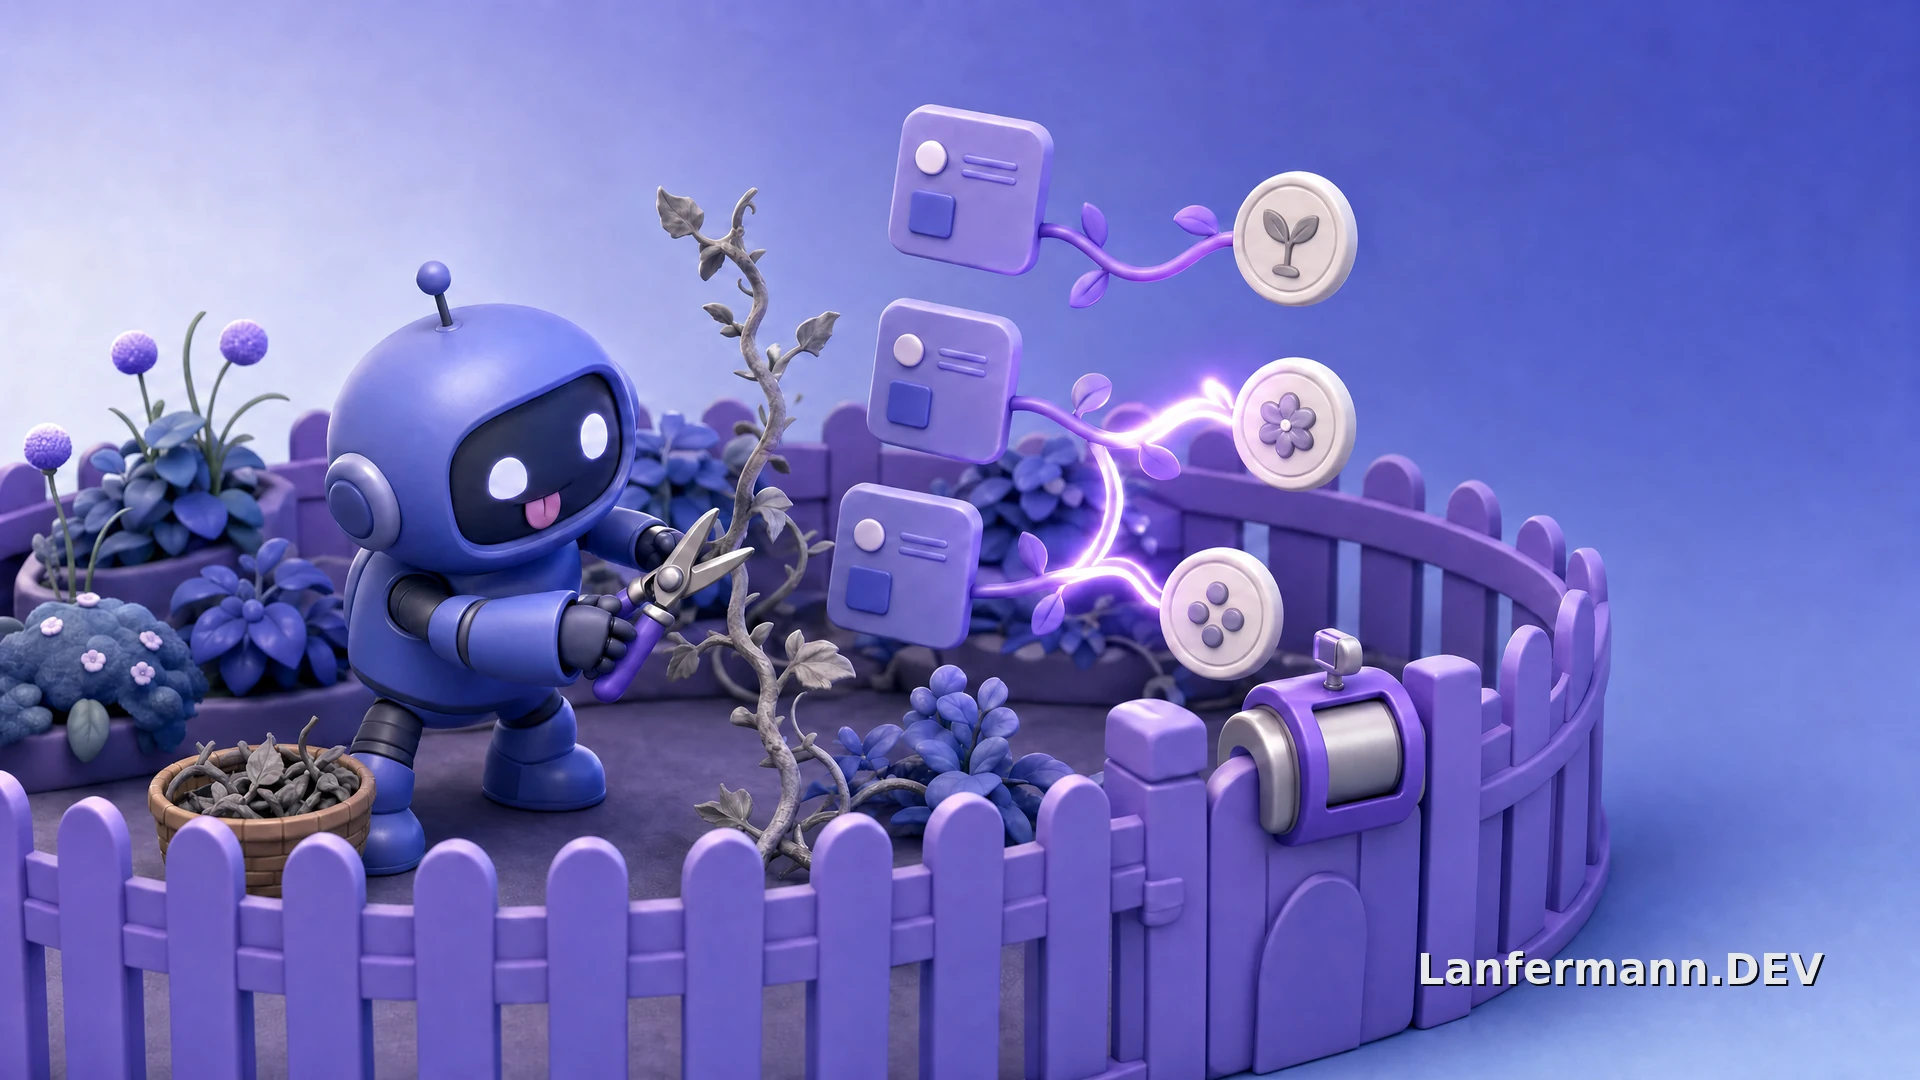
Die Aufteilung, bei der ich gelandet bin, ist schnell erklärt. Das Modell entscheidet, was sich ändern soll. Artemis entscheidet, wie viel das Modell tun darf, wo es das tun darf und wann ein Lauf als erledigt gilt. Jede Sicherheitseigenschaft steckt in Java, nicht in einem Prompt. Ob das hält und was es kostet, ist der Rest der Geschichte.
Warum es auf aktuelle Verknüpfungen ankommt
Die Kompetenzfunktionen von Artemis stecken in einem Modul namens Atlas. Eine Kompetenz ist ein angestrebtes Lernergebnis mit einer Bloom-Stufe, und eine Kompetenzverknüpfung verbindet sie mit einer Übung oder einer Vorlesungseinheit. Diese Verknüpfungen sind das Rohmaterial der Auswertungen. Eine Übung ohne Verknüpfung trägt nichts zu der Kompetenz bei, die sie eigentlich trainiert. Eine Verknüpfung, die eine Überarbeitung überlebt hat, schickt Lernaktivität an eine Kompetenz, die die Übung gar nicht mehr abdeckt.
Das hat echte Folgen. In einer Studie zu einem Kurs mit 1.278 Studierenden fanden Anzinger et al. (mein Betreuer ist Erstautor), dass Studierende, die Atlas freiwillig nutzten, größere Lernfortschritte und höhere Bestehensquoten zeigten als die, die es nicht taten. Die Autoren weisen ausdrücklich darauf hin, dass das Beobachtungsdesign keine Kausalität belegt. Aber wenn sich Studierende auf diese Zahlen verlassen, müssen die Zahlen dem Kursinhalt folgen.
Vor meiner Arbeit gab es in Artemis schon drei Arten von KI-Unterstützung für Kompetenzverknüpfungen: den dialogbasierten Atlas Chat, AtlasML-Vorschläge im Übungseditor und eine Checkliste im Hyperion-Modul zum Erstellen von Übungen. Alle drei warteten darauf, dass eine Lehrperson fragt. Die Editor-Vorschläge und die Checkliste betrachteten jeweils eine einzelne Übung, keine der drei kümmerte sich um Vorlesungseinheiten, und keine bewertete Verknüpfungen neu, wenn sich Inhalte änderten.
Wie ich zu diesem Thema kam
Mein Betreuer, Maximilian Anzinger, war im iPraktikum mein Teamleiter. Als ich ihn nach einem Thema für die Bachelorarbeit gefragt habe, hatte er diese Idee und hat mir das Design fast komplett selbst überlassen. Mein Prüfer war Prof. Dr. Stephan Krusche, dessen Forschungsgruppe Artemis entwickelt. Ich hatte also eine echte produktive Codebasis, ein echtes Problem und niemanden, der mir eine Architektur vorgab.
Schon bevor die Arbeit am 27. Mai 2026 offiziell begann, habe ich im Atlas-Code mitgearbeitet. Im Atlas Chat hat der Hauptagent Arbeit abgegeben, indem er buchstäblich %%ARTEMIS_DELEGATE_TO_COMPETENCY_EXPERT%% in seine Antwort schrieb. Einer meiner ersten Beiträge hat dieses Routing durch richtige Spring-AI-Tool-Calls ersetzt (#12373). Diese Marker sind ein kleines Beispiel dafür, wie eine Anwendung freiem Text aus einem Modell vertraut. Genau das zu vermeiden, zieht sich durch das ganze Design.
Das Beängstigende ist die Autonomie
Ein Freigabedialog verdeckt viele Probleme, weil ein Mensch die seltsamen Fälle abfängt. Sobald Änderungen direkt in die Datenbank gehen, landet jeder Fehlerfall, den dieser Dialog früher geschluckt hat, bei einem selbst:
- Riskante Tool-Nutzung. Forschung wie ToolEmu zeigt, dass Agenten mit Tools bei unterspezifizierten Anweisungen riskante Aktionen ausführen, auch der sicherste Agent, den die Autoren untersucht haben. Ein Prompt, der sagt „Fass nur diesen Kurs an", ist eine Hoffnung, keine Garantie.
- Nebenläufigkeit. Artemis läuft auf mehreren Servern. Zwei Inhaltsänderungen im selben Kurs können zwei Läufe starten, die sich widersprechende Änderungen schreiben.
- Kostenschleifen. Lehrende speichern oft. Wenn jedes Speichern einen Modellaufruf auslöst, wird aus einem vollen Nachmittag eine Rechnung. Wenn die eigenen Schreibzugriffe des Agenten neue Läufe auslösen, wird daraus eine Schleife.
- Herkunft. Wenn Lehrende nicht erkennen können, welche Verknüpfungen eine KI angelegt hat, können sie diese später auch nicht prüfen.
Deshalb habe ich für das ganze Design eine Regel festgelegt: Alles, was garantiert gelten muss, gehört in den Anwendungscode. Prompts bestimmen die Qualität der Entscheidungen. Für Sicherheit sind sie nie zuständig.
Das Modell entscheidet was, Artemis entscheidet den Rest
Ein Wartungslauf startet auf einem von zwei Wegen. Eine Lehrperson kann ihn für eine Übung oder Vorlesungseinheit auslösen. Oder, in Kursen, in denen ein Admin das aktiviert hat, sammelt Artemis Inhaltsänderungen und startet einen Batch, sobald im Kurs für ein einstellbares Zeitfenster Ruhe ist. In beiden Fällen läuft alles durch dieselbe Pipeline.
Innerhalb des Laufs arbeitet ein Orchestrator in einer ReAct-Schleife. Er startet mit den geänderten Inhalten und einem kompakten Index des Kurses: jede Kompetenz, ihre verknüpften Übungen und Vorlesungseinheiten, ihre Beziehungen und eine eigene Liste der Übungen ganz ohne Verknüpfung. Braucht er mehr, fragt er gezielt Details zu einzelnen Elementen ab. Diese schrittweise Offenlegung hält den Prompt klein und lässt den Orchestrator trotzdem alles im Kurs abfragen.
Das Modell entscheidet was
Artemis setzt durch, wie viel, wo und wann es als erledigt gilt
Architektonisch ist das ein Orchestrator-Worker-Setup mit mehreren Agenten, gebaut auf dem Tool-Calling von Spring AI: Jedes Tool ist eine Java-Methode, die Artemis ausführt, während das Modell nur das Tool und seine Argumente benennt. Der Orchestrator schreibt selbst nie etwas. Er delegiert an drei Worker, jeder mit eigenem Prompt und einem bewusst kleinen Tool-Set. Der Assigner verknüpft Übungen und Vorlesungseinheiten, löst Verknüpfungen oder gewichtet sie neu. Der Creator legt Kompetenzen an. Der Editor ändert Titel, Beschreibung oder Bloom-Stufe einer Kompetenz und darf sie nur löschen, wenn keine Verknüpfungen mehr bestehen. Worker sehen die Unterhaltung des Orchestrators nicht, haben kein Gedächtnis zwischen Aufgaben und können nicht weiterdelegieren. Jede zusätzliche Delegation kostet einen weiteren Modellaufruf, aber durch diese Isolation bleibt der Spielraum jedes Workers leicht überschaubar.
Drei Leitplanken, auf die ich stolz bin
Flavor-Stripping, das nur löschen kann
Aufgabenstellungen lieben Geschichten. An der TUM brauchen erstaunlich viele Pinguine Hilfe. Diese Rahmenhandlung ist gute Didaktik, aber Rauschen, wenn man entscheiden will, welche Kompetenz eine Übung trainiert, und sie kostet bei jedem Lauf Tokens. Deshalb entfernt ein Vorverarbeitungsschritt diesen Flavor-Text, bevor der Orchestrator den Inhalt sieht.
Der naheliegende Weg wäre, ein Modell die Aufgabe ohne Geschichte neu schreiben zu lassen. Das habe ich bewusst nicht gemacht, weil ein Rewrite unbemerkt einen Methodennamen oder ein gefordertes Ausgabeformat verändern kann. Stattdessen liefert das Modell eine Liste von Suchen-und-Ersetzen-Edits, und Artemis wendet sie selbst an. Unten ein ausgedachtes Beispiel für dieses Format und die Schleife, die es anwendet (gekürzt, Kommentare von mir):
1// Input statement (illustrative)2The zoo penguins have lost track of their fish supply. Help them out!3Implement sortByWeight(List<Fish>): List<Fish> so that ...45// What the flavor-strip model returns6{7 "edits": [8 {9 "reasoning": "Story framing; the next sentence is the spec.",10 "search": "The zoo penguins have lost track of their fish supply. Help them out!",11 "replace": ""12 }13 ]14}1for (EditDTO edit : edits) {2 String replacement = edit.replace() == null ? "" : edit.replace();3 if (replacement.length() > 1) {4 continue; // a rewrite, not a deletion: never trusted5 }6 int[] span = findSpan(working, edit.search()); // exact, then whitespace-tolerant7 if (span == null) {8 continue; // off-target span: skip, don't guess9 }10 working = working.substring(0, span[0]) + replacement + working.substring(span[1]);11}Ein Edit, dessen Ersetzung länger als ein Zeichen ist, wird verworfen. Ein Edit, dessen Textstelle sich nicht finden lässt (toleriert werden nur Unterschiede im Whitespace), wird übersprungen. Schlägt der Aufruf fehl oder ist das Ergebnis leer, nimmt Artemis den Originaltext. Das Modell kann Erzählung löschen, aber die Spezifikation nicht umschreiben: Jedes Wort, das es behält, bleibt genau so stehen, und Artemis räumt danach nur den Whitespace auf. Selbst die Feldreihenfolge ist Absicht. reasoning steht vor search, damit das Modell erst aufschreibt, warum eine Passage Erzählung ist, bevor es sich aufs Löschen festlegt.
Ein Budget, um das sich das Modell nicht herumreden kann
Ein Agent, der so lange weiterläuft, bis er sich fertig fühlt, ist ein Kostenrisiko ohne Obergrenze. Jeder Lauf bekommt ein gemeinsames Budget von 256 Tool-Calls für den Orchestrator und alle seine Worker. Lesezugriffe zählen. Fehlgeschlagene Aufrufe zählen. Jeder Aufruf wird vom Budget abgebucht, bevor das Tool läuft, damit parallele Aufrufe das Budget nicht überziehen können, und eine Delegation an einen Worker setzt den Zähler nicht zurück. Zusätzlich darf ein Lauf höchstens 16 Mal delegieren.
Nach 224 Aufrufen schaltet der Lauf in den Abschlussmodus: Schreibzugriffe und Delegationen werden abgelehnt, nur Lesen und Abschließen sind noch erlaubt. So bleiben die letzten 32 Aufrufe dafür reserviert, dass die Agenten prüfen, was sie getan haben, und ehrlich berichten. Die Grenze ist schlichtes Java:
1/** Maximum number of autonomous tool callbacks in one top-level run. */2public static final int LIMIT = 256;34/** Work stops here; the remaining callbacks are reserved for verification and completion. */5public static final int WRAP_UP_AT = LIMIT - 32;„Fertig" muss man sich verdienen
Subtiler als ein falscher Schreibzugriff ist ein Agent, der behauptet, fertig zu sein, obwohl er es nicht ist. Deshalb kann der Orchestrator einen verifizierten Erfolg nur melden, nachdem er den Kursindex nach seiner letzten Änderung frisch gelesen hat. Der Index aus dem ursprünglichen Prompt zählt nicht. Das ist die Prüfung, die das durchsetzt:
1public synchronized void complete(boolean verified, String message) {2 if (completion != null) {3 throw new IllegalStateException("completeOrchestration was already called.");4 }5 if (activeWork != 0) {6 throw new IllegalStateException("Wait for active work before completing orchestration.");7 }8 if (verified && (verifiedVersion != mutationVersion || workBlocked() || exhausted())) {9 throw new IllegalStateException(10 "verified=true requires a successful index refresh after the latest work, "11 + "with no budget-blocked work.");12 }13 completion = new OrchestrationCompletionDTO(verified, message);14}Schlägt diese Prüfung fehl oder schließt der Orchestrator gar nicht ab, endet der Lauf als Failed, oder als Partial, wenn schon Änderungen durchgegangen sind. Artemis tut nicht so, als wäre ein halber Lauf sauber gewesen: Jedes Ergebnis listet alle Änderungen, die vor dem Fehler angewendet wurden. Um diese drei Leitplanken herum stehen die klassischeren:
- Kursgrenzen und Nebenläufigkeit. Der aktive Kurs kommt aus vertrauenswürdigem Serverkontext, nie aus der Modellausgabe, und ein Lesezugriff auf ein Objekt außerhalb des Kurses liefert nichts. Eine Sperre pro Kurs im gemeinsamen Zustand von Artemis (Hazelcast oder Redis) sorgt dafür, dass eine parallele Anfrage die Antwort In progress bekommt statt eines zweiten Laufs.
- Lehrende und Admins behalten die Kontrolle. Der automatische Modus ist standardmäßig aus. Admins aktivieren ihn pro Kurs und legen das Ruhefenster und ein tägliches Laufkontingent fest. Änderungen an Kompetenzverknüpfungen lösen nie einen Lauf aus, damit sich die Agenten nicht selbst anstoßen.
- Herkunft und Berichte. Jede Kompetenz und Verknüpfung, die eine KI-Funktion anlegt, wird als KI-generiert markiert. Die Markierung wird gespeichert, aber noch nicht in der Oberfläche angezeigt. Lehrende bekommen eine Benachrichtigung für jeden automatischen Lauf, der etwas ändert oder fehlschlägt, und können eine E-Mail aktivieren, die bis zu 50 angewendete Änderungen mit der Begründung des Modells auflistet.
Ausliefern in eine Codebasis, die nicht meine ist
Ein Prototyp auf einem Fork wäre einfacher gewesen. Ich wollte die Arbeit aber im offiziellen Artemis haben. Seit März 2026 habe ich dort 22 Pull Requests eröffnet. 17 sind gemergt, darunter Flavor-Stripping, Kostenerfassung, der automatische Trigger, die Konfiguration pro Kurs, der Orchestrator selbst und das gemeinsame Tool-Budget. Fünf sind noch im Review: die Delegation an Worker, die KI-Herkunftsmarkierungen, die Unterstützung für Vorlesungseinheiten, eine Härtungsrunde und die E-Mail-Berichte. Der vollständige autonome Pfad ist also noch nicht komplett upstream.
In einer Codebasis dieser Größe mitzuarbeiten, prägt die Arbeit auf eine Weise, die man bei einem Soloprojekt nicht erlebt. Reviews brauchen Zeit: Das Aufteilen der Tool-Services in rollenspezifische Tool-Oberflächen war ein Diff von rund 5.000 Zeilen, der von Ende Juni bis Ende August im Review lag. Auch die Testinfrastruktur hat eigene Budgets. Artemis begrenzt, wie viele Spring-Serverkontexte die Integrationstests starten dürfen, und einer meiner Orchestrator-Tests hat die Grenze von zehn überschritten. Der Fix (#13051) war im Wesentlichen eine Löschung von 27 Zeilen. Solche Grenzen zwingen einen, für die CI anderer Leute zu designen, nicht nur für den eigenen Laptop.
Agenten mit Agenten bauen
Ich habe das mit KI-Coding-Agenten gebaut, und die Arbeit sagt das auch in ihrer KI-Erklärung. Claude Code und Codex haben unter meiner Anleitung den Großteil des Codes und den Großteil der ersten Manuskriptentwürfe erzeugt. Agenten haben auch den synthetischen Kurs erzeugt, gegen den ich gebenchmarkt habe. Die Designentscheidungen habe ich getroffen, jede Änderung habe ich geprüft und getestet, und jede Quelle habe ich mit dem Original abgeglichen.
So zu arbeiten verschiebt den Engpass vom Tippen zum Urteilsvermögen: wissen, was man verlangen muss, merken, wenn etwas plausibel aussieht, aber falsch ist, und Prüfungen bauen, statt sich auf sich selbst zu verlassen. Ich habe strukturierte Audit-Durchläufe über jedes Kapitel und über die Quellen laufen lassen und ihre Befunde wie Review-Kommentare behandelt, die ich annehme oder ablehne. Das ist dieselbe Philosophie wie beim System selbst: Das Modell produziert, die Prüfung ist deterministisch.
Der Benchmark, oder: One more thing
Mein Betreuer und ich haben einen Kostenmaßstab vereinbart. Wir haben angenommen, dass es eine Tutorin oder einen Tutor mindestens eine Stunde kostet, drei oder vier Kompetenzen von Hand anzulegen. Beim deutschen Mindestlohn 2026 von 13,90 €, aufgerundet, ergibt das eine Obergrenze von 15 € pro Lauf. Das war die Messlatte für jeden automatischen Lauf.
Die Grundlage ist ein synthetischer Kurs mit 60 Übungen aller fünf Übungstypen, 12 Vorlesungseinheiten und 12 Referenzkompetenzen zu 12 Einführungsthemen der Informatik. Für jeden primären Lauf hat ein Benchmark-Runner über die normalen Artemis-APIs einen frischen Kurs angelegt, eine von sechs Bedingungen hergestellt, die Inhaltsänderungen angewendet und das Ergebnis aufgezeichnet. Die Bedingungen decken eine einzelne Übung ab, eine einzelne Vorlesungseinheit, einen vollständig gepflegten Kurs, in dem sich nichts ändern sollte, die Zuordnung zu bestehenden Kompetenzen, einen zur Hälfte fehlenden Kompetenzsatz (gemischt) und einen Bootstrap, der ganz ohne Kompetenzen startet. Sechs Bedingungen mal zehn Wiederholungen in zufälliger Reihenfolge ergaben 60 Läufe. Jeder Bootstrap-Kurs lief danach noch drei weitere Batches, das sind 30 Läufe mehr, insgesamt also 90, alle mit gpt-5.6-luna. Jede Anfrage an den Anbieter lief durch einen lokalen Zähler, sodass sich jede Kostenzahl aus den veröffentlichten Daten nachrechnen lässt.
Anbieterkosten pro Wartungslauf, in Euro-Cent
90 Läufe, ein Punkt pro Lauf. Linien reichen vom günstigsten bis zum teuersten Lauf, Rauten markieren den Median.
Stufen 2 bis 4 setzen den Kurs aus Stufe 1 fort
Tippe auf einen Punkt, um seine genauen Kosten zu sehen.
Ziel: 1.500 ct (15 €, eine Tutorenstunde). Teuerster Lauf: 5,36 ct.
Zahlen anzeigen
| Gruppe | Min. | Median | Max. |
|---|---|---|---|
| Einzelne Übung | 0,20 | 0,37 | 0,59 |
| Vorlesungseinheit | 0,22 | 0,45 | 0,69 |
| Gepflegter Kurs | 0,63 | 1,16 | 1,78 |
| Zuordnung | 1,52 | 1,91 | 2,56 |
| Gemischt | 1,74 | 2,06 | 2,40 |
| Bootstrap, Stufe 1 | 2,04 | 2,84 | 2,95 |
| Bootstrap, Stufe 2 | 3,10 | 4,00 | 5,36 |
| Bootstrap, Stufe 3 | 3,27 | 3,73 | 4,05 |
| Bootstrap, Stufe 4 | 2,11 | 2,28 | 3,02 |
Alle 90 Läufe wurden abgeschlossen: 68 haben Änderungen vorgenommen, 22 haben entschieden, dass nichts zu ändern war. Der teuerste einzelne Lauf kostete etwa 0,054 €, also 0,36 Prozent des Ziels. Eine komplette Kompetenzstruktur für alle 72 Lernobjekte des Kurses von null aufzubauen, über alle vier Bootstrap-Stufen, kostete höchstens 0,14 €. Die gesamte Messreihe kostete 1,88 €, und jede ihrer 2.475 Anfragen an den Anbieter ist abgerechnet.
Spannender als die Summe war die Aufschlüsselung. Die Orchestrierung macht 49 Prozent der Kosten aus, während die Worker die meisten Anfragen stellen. Cache-Lesezugriffe machen 79,8 Prozent aller Input-Tokens aus, aber nur 12,7 Prozent der Kosten. Wiederholter Kontext ist also billig, bezahlt wird vor allem neu geschriebener Kontext und Reasoning-Output. Auch Hinschauen ist nicht umsonst: Läufe auf einem bereits korrekten Kurs machten etwa drei Viertel so viele Lesezugriffe wie Läufe, die Verknüpfungen zuordnen mussten, und kosteten etwa 60 Prozent davon, ohne etwas zu schreiben. Kein Lauf hat mehr als 127 seiner 256 Tool-Calls gebraucht.
Was ich nicht bewiesen habe
Der Benchmark misst Kosten und Ausführungsverhalten. Er misst nicht, ob die Entscheidungen der Agenten gut sind. Manche Ergebnisse waren sehr konsistent, zum Beispiel zwölf neue Kompetenzen in jeder ersten Bootstrap-Stufe und sechs in neun von zehn gemischten Läufen. Andere nicht: Fertige Bootstrap-Kurse endeten mit 16 bis 28 Kompetenzen. Und konsistent hieße ohnehin nicht korrekt. Das zu beurteilen braucht Lehrende, die echtes Kursmaterial prüfen, und genau das würde ich als Nächstes angehen. Weitere bekannte Lücken:
- Flavor-Stripping ist strukturell sicher, aber inhaltlich nicht validiert. Das Modell kann die Spezifikation nicht umschreiben, aber noch hat niemand geprüft, ob es jemals etwas löscht, das eine Kompetenzentscheidung gebraucht hätte.
- Die Kurssperre kann nach 30 Minuten ersetzt werden, ohne den ursprünglichen Lauf zu stoppen. Das habe ich gegen Ende der Implementierungsphase in meinem eigenen Audit gefunden. In diesem Fall könnten zwei Läufe gleichzeitig in denselben Kurs schreiben. Der längste Benchmark-Lauf dauerte 341 Sekunden, eine Überschneidung bräuchte also einen Lauf, der mehr als fünfmal so lang ist wie alles, was ich gemessen habe. Die Arbeit beschreibt den Fehlerfall genau, und er steht ganz oben auf der Fix-Liste.
- Die Herkunftsmarkierung vertraut stellenweise noch dem Client, und Lehrende sehen sie noch nicht. Manche Endpunkte setzen die KI-Markierung danach, welchen Endpunkt der Client gewählt hat, nicht nach serverseitigen Belegen, und die Oberfläche zeigt die Markierung nicht an.
- Der Schutz gegen Prompt Injection ist unvollständig. Kurstext wird in den wichtigsten Prompt-Pfaden bereinigt, aber nicht überall, wo er ein Modell erreicht.
- Manche Zäune wurden kaum beansprucht. Kein Lauf hat den Abschlussmodus oder das Budgetlimit erreicht, und nur zwei Läufe haben an den Editor delegiert. Diese Pfade sind also getestet, aber nicht gemessen. Außerdem wurde der Benchmark-Kurs mit demselben Modell (
gpt-5.6-luna) geschrieben, das gebenchmarkt wurde, und das könnte Inhalte begünstigen, mit denen es gut umgehen kann.
Ein System, das ohne Freigabe schreibt, sollte man an seinen Schwachstellen messen, also benenne ich sie lieber selbst.
Wo es jetzt steht
In meiner Verteidigung habe ich einen echten Wartungslauf live gestartet. Früh im Vortrag habe ich eine vorbereitete Übung bearbeitet, die Architektur erklärt, während der Lauf arbeitete, und gegen Ende das Ergebnis angeschaut. Er war fertig. Ein Live-Agent in einem Abschlussvortrag ist ein Wagnis, deshalb hatte ich für jeden Ausgang etwas vorbereitet, von „läuft noch" bis „teilweise erledigt".
Die Arbeit ist abgegeben, die Note steht noch aus. Die gemergten Teile sind im offiziellen Artemis, die übrigen Pull Requests sind im Review. Die wichtigste Erkenntnis gilt für alles, bei dem ein Modell mitentscheidet: Die nützliche Ingenieursarbeit bei autonomen Agenten ist der Zaun, nicht der Agent. Das Modell entscheidet, was sich ändern soll. Die Anwendung entscheidet, wie viel, wo und wann es als erledigt gilt. Denselben Ansatz habe ich, in viel kleinerem Maßstab, schon beim sich selbst pflegenden Apple Wallet Support Tracker verfolgt.
Ressourcen
- Artemis auf GitHub, die Open-Source-Lernplattform
- Meine Artemis-Pull-Requests, gemergt und im Review
- Veröffentlichte Benchmark-Daten und die Offline-Analyse, um jede Kostenzahl nachzurechnen
- Anzinger et al., Investigating Student Interaction with Competency-Based CS Education