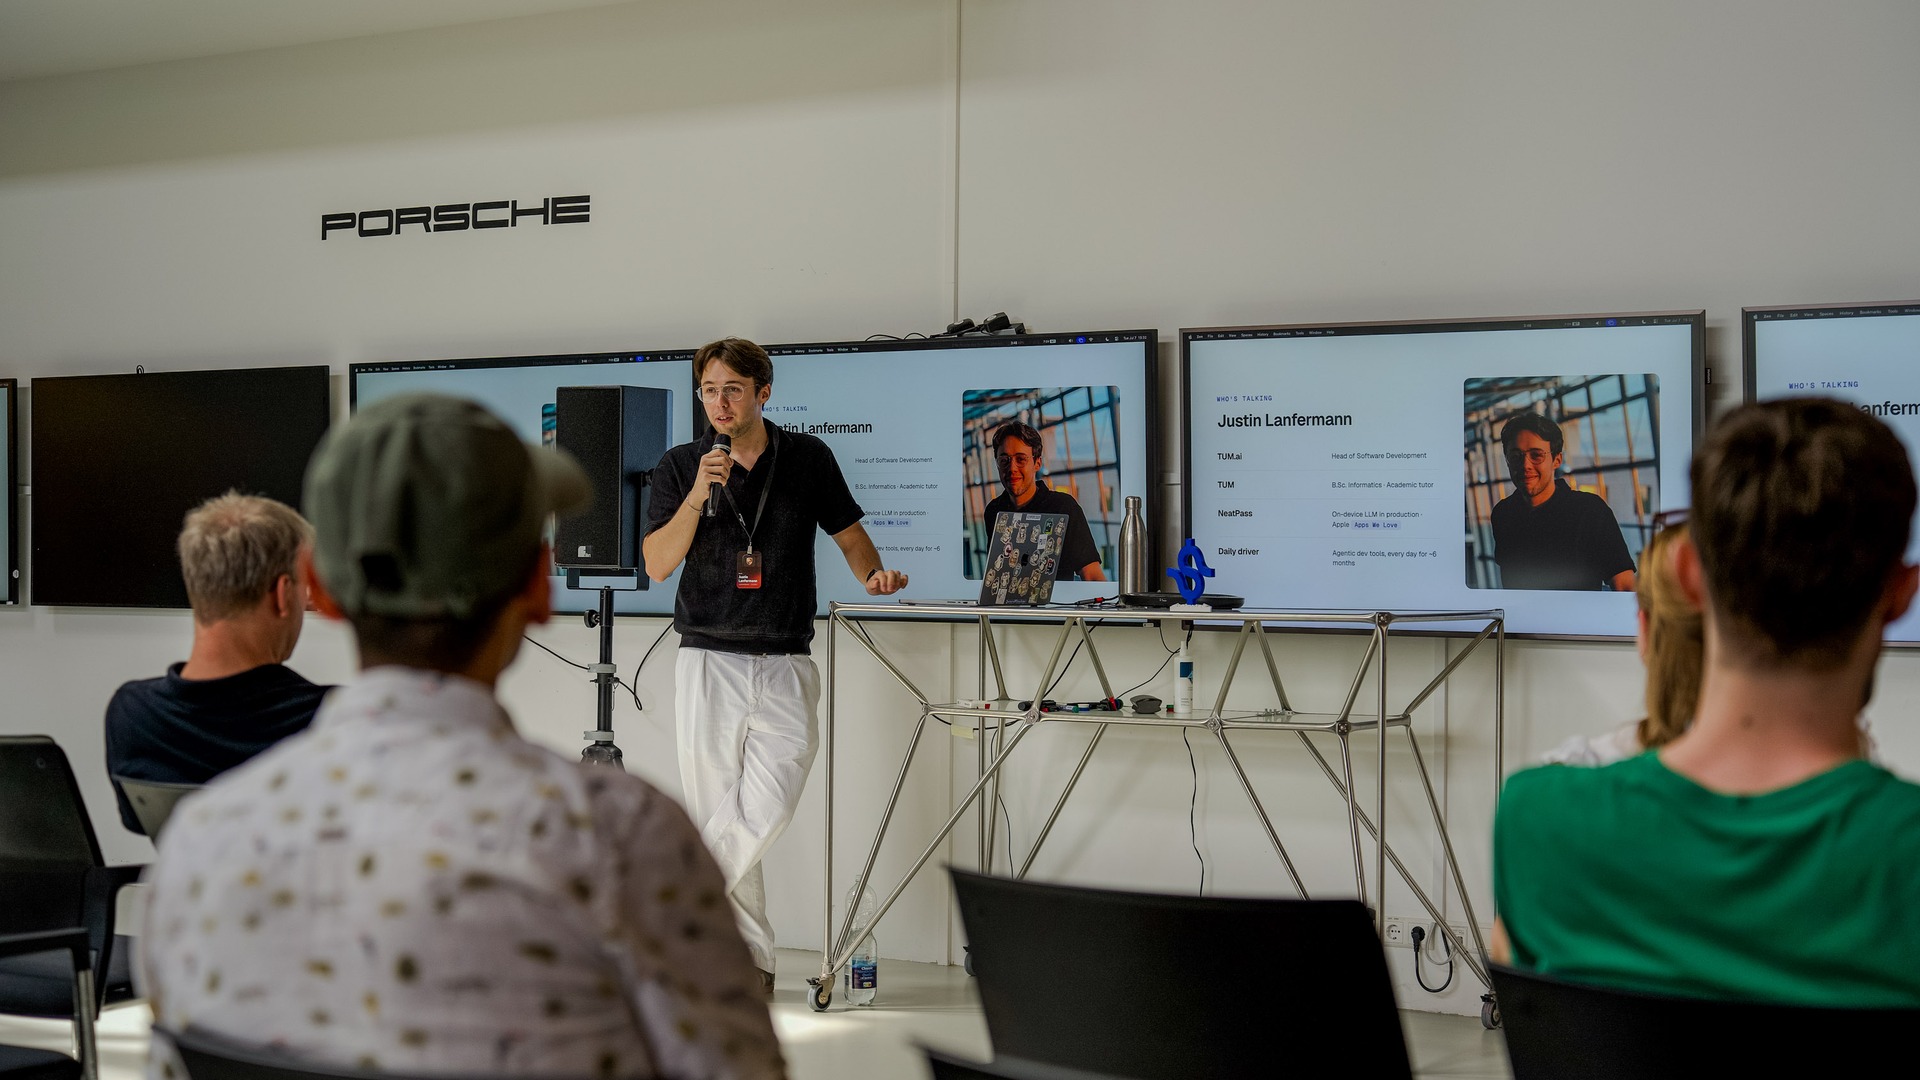
Am 7. Juli 2026 stand ich beim My Porsche App Tech Day in Ludwigsburg vorne im Raum, das Mikrofon in der einen Hand und eine ziemlich klare These auf allen Bildschirmen hinter mir: Nicht jede On-Device-KI ist Apple Intelligence. Mein Freund Jonathan hatte mir geholfen, überhaupt in diesen Raum zu kommen. Die nächsten neunzig Minuten lagen dann bei mir.
Ich war auf eine sehr konkrete Art nervös. Ich war ein gutes Stück jünger als die meisten Menschen vor mir, und viele von ihnen hatten länger Software ausgeliefert, als ich Informatik studiert hatte. Dazu kam, dass ich keinen unverfänglichen Überblick halten wollte. Ich wollte argumentieren, dass Apples Foundation Models auf Apple-Plattformen nur eine Option sind und Open-Weight-Modelle über MLX für ein echtes Produkt die praktischere Grundlage sein können.
Damit verändert sich die Vorbereitung. Eine schöne Folie reicht nicht, wenn der Raum die Annahme darunter auseinandernehmen kann. Hinter jeder Zahl musste eine Messung stehen, hinter jedem Vergleich eine Einschränkung, und jeder selbstbewusste Satz musste die nächste Frage überstehen. Ich habe dabei gelernt: Die unerfahrenste Person im Raum zu sein, ist handhabbar. Leichtfertig mit den Belegen umzugehen, ist es nicht.
Eine These mit eingebauter Angriffsfläche
Auf Apple-Plattformen wird der Begriff On-Device-KI zunehmend mit Apple Intelligence gleichgesetzt. Das ist nachvollziehbar. Apple kontrolliert das Betriebssystem, liefert ein Systemmodell aus und gibt Entwicklern mit dem Foundation-Models-Framework native APIs für geführte Generierung und Tool Calling. Es ist die naheliegende Option, die man zuerst prüft.
Es ist nicht die Option, auf der ich NeatPass gebaut habe. NeatPass verwandelt Screenshots, PDFs oder Fotos von Tickets in Apple-Wallet-Pässe, ohne die Quelldatei hochzuladen. Ein kleines Qwen-Modell liegt in der App und läuft auf dem Telefon über mlx-swift. Das Modell übernimmt das unscharfe Lesen; deterministischer Code kümmert sich um Barcode, Validierung, Signatur und Pass-Erstellung. Diese Architektur wird bereits von mehr als 37.500 Menschen genutzt und hat über 400.000 Pässe erzeugt.
Der Vortrag war also keine Spekulation über eine mögliche Zukunft. Ich hatte ein Produkt in der Tasche, dessen On-Device-Modell bis zurück zum iPhone 12 funktioniert, auch auf Geräten ohne Apple Intelligence. Der Download ist größer, weil die Weights mit der App ausgeliefert werden. Dafür ist das Modell gemeinsam mit dem Produkt versioniert, funktioniert in jedem unterstützten Markt und kann nicht über Nacht durch ein Betriebssystem-Update ausgetauscht werden.
Die stärkste Version dieses Arguments musste Apples Vorteile trotzdem stehen lassen. Das Systemmodell kostet im App-Bundle kein einziges Byte. Die API für strukturierte Ausgaben ist hervorragend. Das native Tool-Protokoll braucht deutlich weniger Plumbing als ein selbst gebauter Loop. Hätte ich den Vergleich als sechs Niederlagen für Apple präsentiert, hätte ihn jemand im Raum zu Recht zerlegt. Die eigentliche Frage war, welche Einschränkungen für ein bestimmtes Produkt zählen, nicht welches Logo gewinnt.
Sechs Runden, eine Maschine
Ich stellte Apples Foundation Model in sechs Runden Qwen- und SmolLM-Modellen über MLX gegenüber: Latenz und Durchsatz, strukturierte Ausgabe, Tool Calling, Kontext, Speicherbedarf und Fehlermodi. Gemessen wurde auf einem Apple M2 Pro. Für den Latenztest nutzte ich denselben langen Prompt, fünf Durchläufe pro Modell und den Median. Apples Framework gibt keine Tokenanzahl aus. Deshalb kennzeichnete ich den Durchsatz als Schätzung aus Zeichen, statt so zu tun, als würden beide APIs identische Daten liefern.
Drei Ergebnisse trugen den größten Teil des Arguments:
- Start und Stream. Auf meinem M2 Pro lieferte SmolLM2 1.7B das erste Token nach 218 ms, Apples Modell nach 447 ms. Danach kamen die offenen Modelle auf 106 bis 110 Tokens pro Sekunde; Apples geschätzter Durchsatz lag bei ungefähr 65. Maschine, Prompt, Anzahl der Durchläufe und Schätzmethode standen direkt auf der Folie, damit die Zahlen als konkrete Messwerte angreifbar blieben.
- Reichweite und Kontrolle. Ein Modell mit ein bis zwei Milliarden Parametern läuft auf deutlich mehr Telefonen, die Menschen bereits besitzen. Wer die Weights ausliefert, erhält außerdem eine Modellversion, die sich testen und stabil halten lässt.
- Form ist nicht Wahrheit. Apple kann eine erzeugte Swift-Struktur garantieren, offene Modelle können JSON per Grammatik absichern. Keine der Garantien sagt, dass Veranstaltungsort, Sitzplatz oder Tool-Argument inhaltlich stimmen. Beide Wege brauchen weiterhin Validierung und Guardrails.
iOS 27 lieferte mir noch vor dem Termin bei Porsche eine bessere Version meines eigenen Arguments. Apple hatte AFM 3, ein Kontextfenster von 8.192 Tokens und ein Sparse-Modell mit 20 Milliarden Parametern für die neueste Hardware angekündigt. Zum Zeitpunkt des Vortrags ließen sich diese Modelle nicht unabhängig benchmarken. AFM 3 wurde in der EU nicht auf iPhone oder iPad ausgeliefert, während der Mac davon unberührt blieb. Das 20B-Modell setzte einen Chip der M3-Klasse mit 12 GB Arbeitsspeicher oder ein iPhone 17 Pro voraus. Gleichzeitig öffnete Apple das Foundation-Models-Framework über ein LanguageModel-Protokoll für andere Modelle, einschließlich eines Open-Source-Adapters für MLX. Apple selbst machte damit Platz für On-Device-KI, die nicht Apple Intelligence ist. Die übrigen Produktgrenzen blieben bestehen: Apple verursachte keine zusätzliche Bundle-Größe; offene Modelle boten 32.000 bis 262.000 Tokens Kontext, machten jeden Tool-Schritt sichtbar und ließen sich über ältere Geräte und Märkte hinweg versionieren.
Vor allem endete der Benchmark nicht auf der Folie. Ich hatte ein öffentliches SwiftUI-Lab gebaut, das dieselben Aufgaben auf beide Arten ausführte, und maß die Ergebnisse live im Raum. Man konnte die Uhr bis zum ersten Token beobachten, die strukturierten Ausgaben prüfen und die Modelle auf dem eigenen Mac starten. Die vollständige Methodik und alle sechs Runden stehen in den Folien. Die Kurzfassung für diesen Artikel ist einfacher: Wenn das Publikum eine Behauptung direkt reproduzieren kann, wird sie zu einem viel besseren Ausgangspunkt für Widerspruch.
Der Teil, den man nicht proben kann
Ich hatte ausdrücklich darum gebeten, mich zu unterbrechen. Fragen mitten im Vortrag sind besser als Fragen, die in einer neunzigminütigen technischen Session höflich bis zur letzten Folie aufbewahrt werden. Damit nahm ich mir allerdings auch die sicherste Ausweichmöglichkeit. Ich konnte keinen wackligen Punkt schnell übergehen und hoffen, dass niemand darauf zurückkam.
Die Fragen drehten sich um die Fehlertoleranz im Produkt. Wie viele ungenaue Antworten akzeptieren Nutzer, bevor sie einer Funktion nicht mehr vertrauen? Wie lässt sich eine Modellantwort sauber validieren? An welchen Stellen können deterministische Heuristiken dem Modell Arbeit ganz abnehmen? Wir sprachen darüber, Felder mit der Quelle abzugleichen, unbelegte Werte abzulehnen, einen neuen Versuch mit dem Validierungsfehler als Kontext zu starten und das Modell nur für die wirklich unscharfen Teile einzusetzen. Sobald eine Ausgabe eine echte Fahrzeugfunktion auslösen kann, sind solche Prüfungen kein Feinschliff mehr.
Danach zog ich die Grenze um das Modell deutlich enger. In NeatPass ist es eine fehlbare Komponente: Deterministischer Code liest den Barcode, Heuristiken verarbeiten beschriftete Felder, das Modell liest die mehrdeutigen Felder und eine weitere deterministische Schicht validiert das Ergebnis, bevor der Pass gebaut wird. Die Pipeline rechnet damit, dass das Modell manchmal falschliegt.
Der Benchmark maß die Geschwindigkeit. Im Produktgespräch ging es um die Bedingungen, unter denen eine Ausgabe überhaupt akzeptabel ist: in der Quelle belegte Felder, deterministische Prüfungen, kontrollierte Wiederholungen und keine Aktion bei unbelegten Daten. Diese Bedingungen sind wichtiger als ein paar zusätzliche Tokens pro Sekunde.
Das Risiko, das auf meinen Folien fehlte
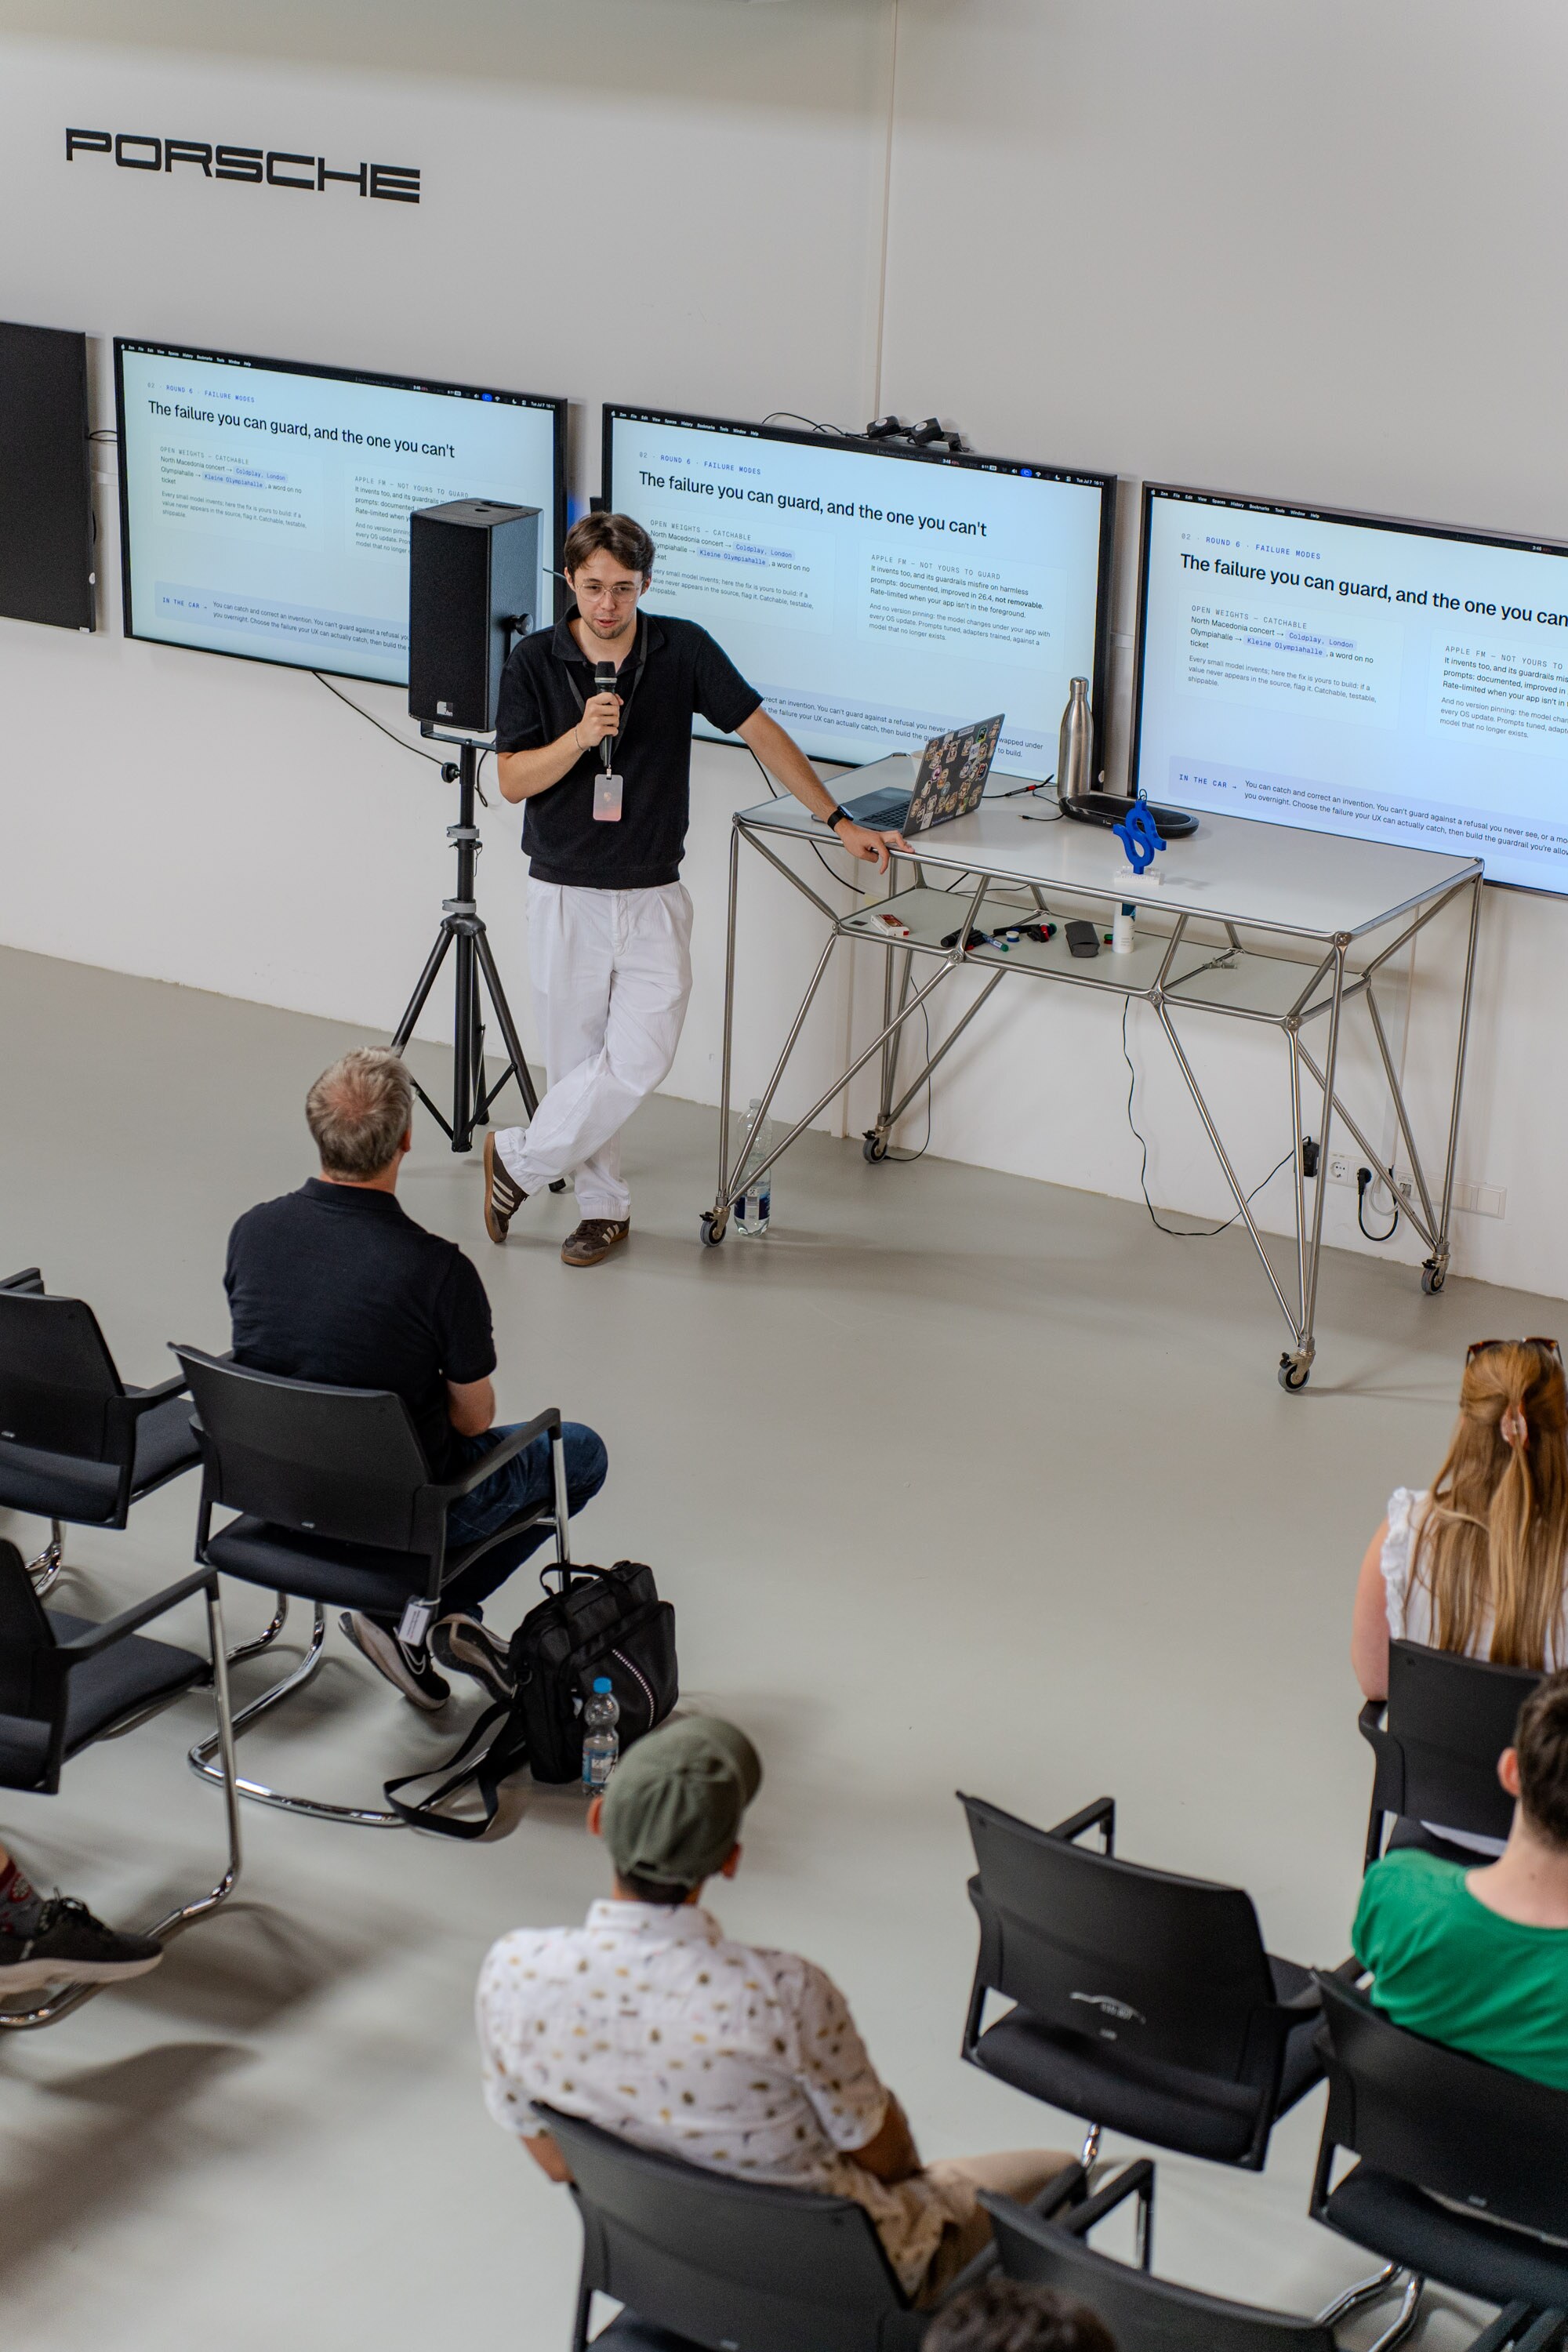
Eines meiner Kernargumente für Open Weights war die Kontrolle über den Fehlermodus. Ein kleines Modell erfindet Dinge. Bei NeatPass wurde aus einem Konzert in Nordmazedonien schon Coldplay in London, und aus einem Olympiahalle-Ticket die Kleine Olympiahalle, obwohl dieses zusätzliche Wort nirgends in der Quelle stand. Solche Fehler sind schlecht, aber für meinen Code sichtbar. Ich kann prüfen, ob ein erzeugter Wert im Ticket vorkommt, ihn ablehnen, einen neuen Versuch starten und das Modell festschreiben, während ich den Guardrail verbessere.
Das Systemmodell bringt Fehler mit, die eine App weniger direkt kontrolliert: Ein Guardrail kann einen harmlosen Prompt ablehnen, die Verfügbarkeit kann von Hardware oder Region abhängen, und das Modell kann sich mit dem Betriebssystem verändern. Mein Satz im Vortrag lautete, den Fehler zu wählen, den die eigene UX tatsächlich abfangen kann. Der Satz bleibt nützlich. Die Diskussion zeigte aber einen Preis, den ich nicht daneben gestellt hatte.
Wenn die Weights im App-Bundle liegen, werden sie an den Nutzer ausgeliefert. Sie lassen sich extrahieren und kopieren. Kontrolle über die Version bedeutet zugleich Verteilung. Bei einem öffentlichen Basismodell wie Qwen ist das erwartbar. Bei einem proprietären oder stark feinabgestimmten Modell, dessen Weights zur schützenswerten IP des Unternehmens gehören, kann es die gesamte Architekturentscheidung verändern.
Das ist keine abstrakte Lizenz-Fußnote. Ein Team kann viel Zeit und Daten investieren, um ein kleines Modell für genau eine Aufgabe ungewöhnlich gut zu machen, und das Ergebnis anschließend in den bequemsten denkbaren Liefermechanismus für jeden verpacken, der es untersuchen möchte. Verschlüsselung kann den Aufwand erhöhen. Die App braucht die nutzbaren Weights am Ende trotzdem auf Hardware, die der Nutzer kontrolliert. Ein Geheimnis, das auf dem Gerät eines anderen entschlüsselt werden muss, lässt sich nur schwer geheim halten.
Für NeatPass kippt das die Architektur nicht. Die Basisgewichte sind ohnehin offen, und der größte Teil des produktspezifischen Werts steckt in der deterministischen Pipeline, den Prompts, der Validierung, den Wiederholungen und der Wallet-Integration rundherum. Das allgemeinere Argument wird dadurch aber genauer. Ein eigenes Modell gibt Kontrolle über Reichweite, Versionen und Guardrails. Es bringt gleichzeitig Risiken für Weitergabe und geistiges Eigentum mit. Der Raum verbesserte die These, indem er die Rechnung hinter dem Vorteil fand.
Die unerfahrenste Person im Raum sein
Vor dem Vortrag betrachtete ich den Erfahrungsunterschied vor allem als Grund, nervös zu sein. Das war nicht völlig irrational. Erfahrene Entwickler erkennen, wenn ein Benchmark ein unfaires Setup versteckt, eine elegante Architektur die Auslieferung ignoriert oder ein selbstbewusster Vortragender seine Sicherheit nur aus einer Grafik leiht. Die Lösung bestand nicht darin, ihre Erfahrung nachzuahmen. Jahre, die ich noch nicht gearbeitet hatte, konnte ich nicht herstellen.
Was ich tun konnte, war, meinen begrenzteren Erfahrungsschatz ungewöhnlich gut prüfbar zu machen. Ich hatte diese Architektur ausgeliefert. Ich hatte den Testaufbau. Ich wusste, welche Zahl exakt war, welche geschätzt wurde, welches Ergebnis nur für meinen M2 Pro galt und wo Apples Lösung tatsächlich besser war. Das machte mich nicht zur Autorität für jedes Fahrzeug- oder KI-System im Raum. Es machte mich verantwortlich für den Teil, den ich behauptete.
Als die Fragen begannen, wurde der Altersunterschied viel unwichtiger, als ich erwartet hatte. Das Gespräch funktionierte, weil ich dem Raum keine Seniorität vorspielen musste. Er brauchte ein konkretes System, angreifbare Messungen und ehrliche Grenzen dafür, was diese Messungen bedeuteten. Im Gegenzug bekam ich Perspektiven, die keine Probe allein hätte hervorbringen können.
Das ist wahrscheinlich die nützlichste Vortragslektion, die ich mitgenommen habe. Selbstvertrauen muss nicht bedeuten, bei allem sicher zu klingen. In einem technischen Raum kann es bedeuten, beim eigenen Wissen präzise zu sein, beim Nichtwissen ruhig zu bleiben und echtes Interesse zu zeigen, wenn jemand ein Risiko findet, das die Vorbereitung übersehen hat.
Was den Raum überstanden hat
Die Hauptaussage überstand den Raum, allerdings mit schärferen Kanten. Apples Foundation Models sind eine starke Option, wenn kein zusätzlicher Bundle-Speicher, native APIs und Systemintegration die Entscheidung dominieren. Open Weights über MLX sind eine starke Grundlage, wenn Gerätereichweite, langer Kontext, Versionsstabilität, Prüfbarkeit oder die freie Modellwahl wichtiger sind. Oft ist die nützliche Architektur überhaupt nicht ideologisch: eigene Weights als verlässliche Basis, das Systemmodell als leistungsfähige Stufe dort, wo es verfügbar ist.
Neu ist die Frage, die ich vor dieser Empfehlung heute ergänzen würde: Was passiert, wenn jemand das Modell extrahiert? Bedroht die Antwort das Geschäft, darf das Modell nicht wie eine gewöhnliche gebündelte Abhängigkeit behandelt werden. Diese Einschränkung gehört neben Latenz, Kontext, Speicherbedarf und Hardware-Reichweite, nicht erst in eine Sicherheitsprüfung, wenn die Architektur längst feststeht.
Ich ging mit der Sorge zu Porsche, dass ein Raum mit mehr Erfahrung die Grenzen meines Arguments offenlegen würde. Genau das geschah, nur nicht auf die Art, die ich befürchtet hatte. Die Messungen hielten. Die Diskussion fand das, was die Messungen nicht abdeckten. Das ist ein deutlich besseres Ergebnis als ein makelloser Vortrag, nach dem die These den Raum exakt so verlässt, wie sie ihn betreten hat.
Der vollständige Benchmark, die Quellen und der Vergleich in sechs Runden stehen in meinen Folien. Das ausführbare On-Device Lab enthält die SwiftUI-Demos und den Headless-Testaufbau. Damit lässt sich jede Zahl auf eigener Apple-Silicon-Hardware prüfen, statt meine einfach zu glauben. Zu diesem Standard hat mich der Raum gedrängt, und genau den möchte ich behalten.